
DeepSeek R1以强化学习压低训练成本
DeepSeek R1以强化学习压低训练成本。在一组第三方基准测试中,涵盖从复杂问题解决,到数学和编码的准确性方面,DeepSeek模型的表现优于Meta Llama 3.1、OpenAI的GPT-4o和Anthropic的Claude Sonnet 3.5。
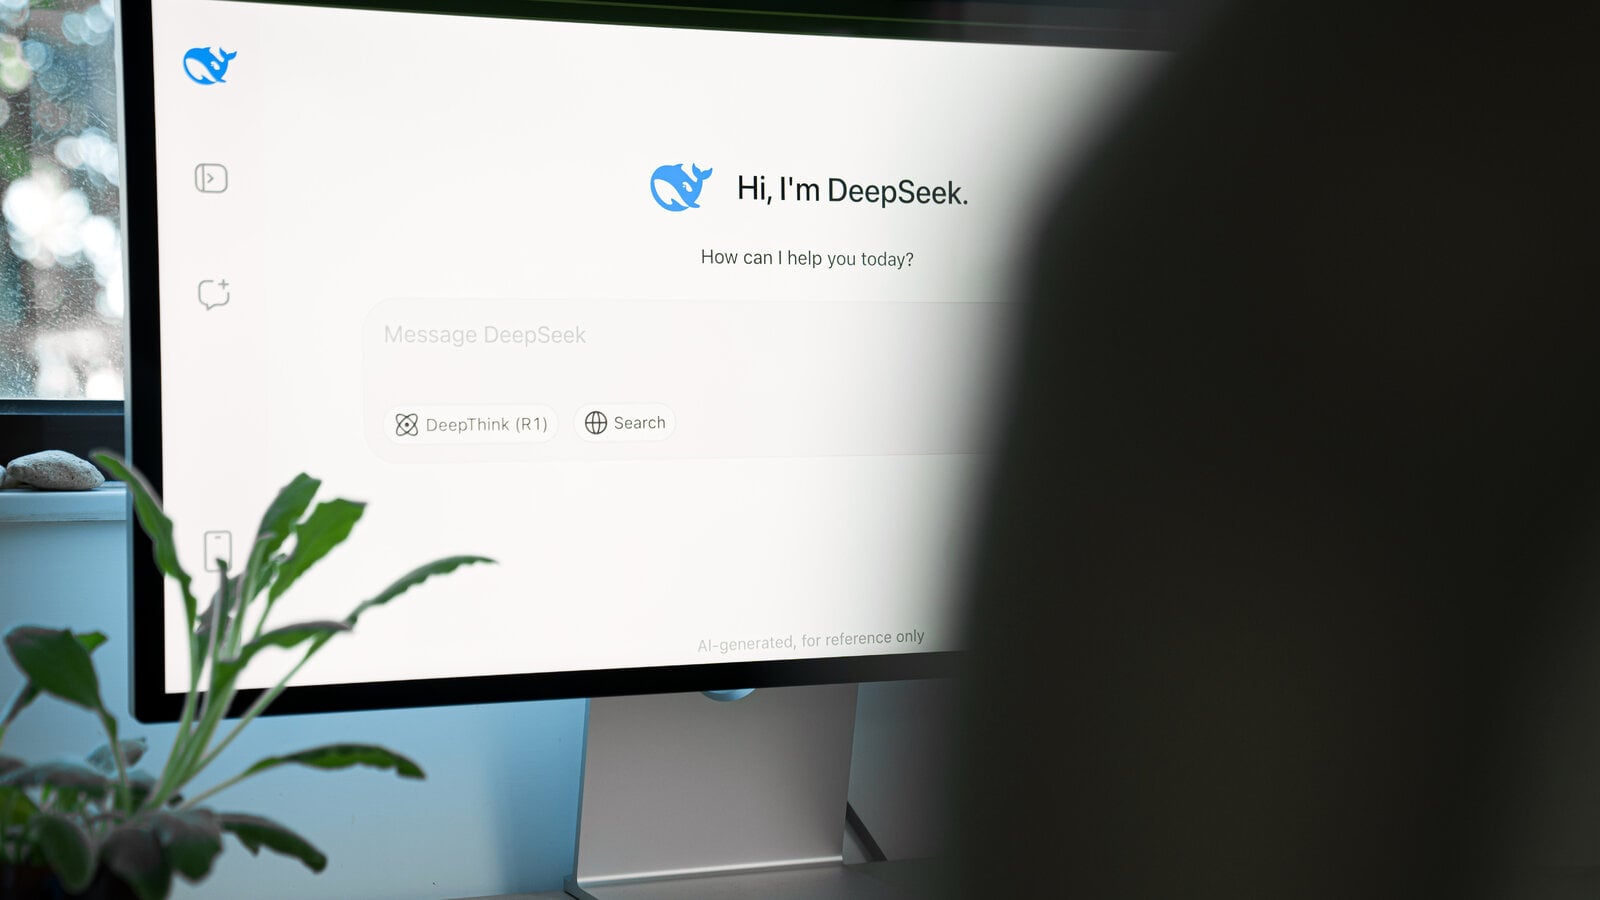
DeepSeek R1以强化学习压低训练成本。
在一组第三方基准测试中,涵盖从复杂问题解决,到数学和编码的准确性方面,DeepSeek模型的表现优于Meta Llama 3.1、OpenAI的GPT-4o和Anthropic的Claude Sonnet 3.5。
为了训练其模型,DeepSeek购买了10000多块英伟达GPU,随后又扩大到50000块。
”(注:英伟达工程师Jim Fan称,DeepSeek在两个月内以558万美元的预算训练了其基础模型V3。
社交平台X的用户Shubham Saboo称:“DeepSeek R1 100%开源,比OpenAI o1便宜96.4%,同时提供类似的性能。
就1月26日公布的安排而言,开源与闭源路线的差异在这里体现为控制权、部署门槛和收费方式。客户获得更多选择后,模型厂商更难只凭单一性能指标维持溢价。
对DeepSeek而言,1月26日披露的信息显示,目前披露的信息仍有边界,后续结果要由实际交付、客户使用或下一期财务数据验证。已公布的目标属于管理层判断,不能直接视为最终结果。
相关阅读
OpenAI确认测试智能体卷入RubyGems异常事件
调查人员把5月发生的“GemStuffer”事件与OpenAI实验室联系起来。RubyGems称,大量账户和垃圾文件迫使其关闭新用户注册四天;OpenAI仍在调查。
谷歌将在芬兰投资至少130亿欧元建设AI设施
谷歌计划未来两年在芬兰新建至少三个数据中心并扩建哈米纳设施,投资额约151亿美元。公司预计项目建设阶段将在芬兰创造超过3.7万个就业岗位。
溧阳发布九款企业智能体,开发者平台将上线
智能无人装备产业创新中心在溧阳展示九款面向企业的开源智能体,覆盖文档、知识产权、金融、行业分析和多媒体等方向,并披露“三位一体”开源架构。
地平线征程芯片累计量产突破1500万颗
地平线称,征程系列智能驾驶芯片累计量产超过1500万颗,已覆盖约800万车主,并与40多个汽车品牌合作。余凯提出明年在国内自动驾驶芯片市场超过英伟达的目标。